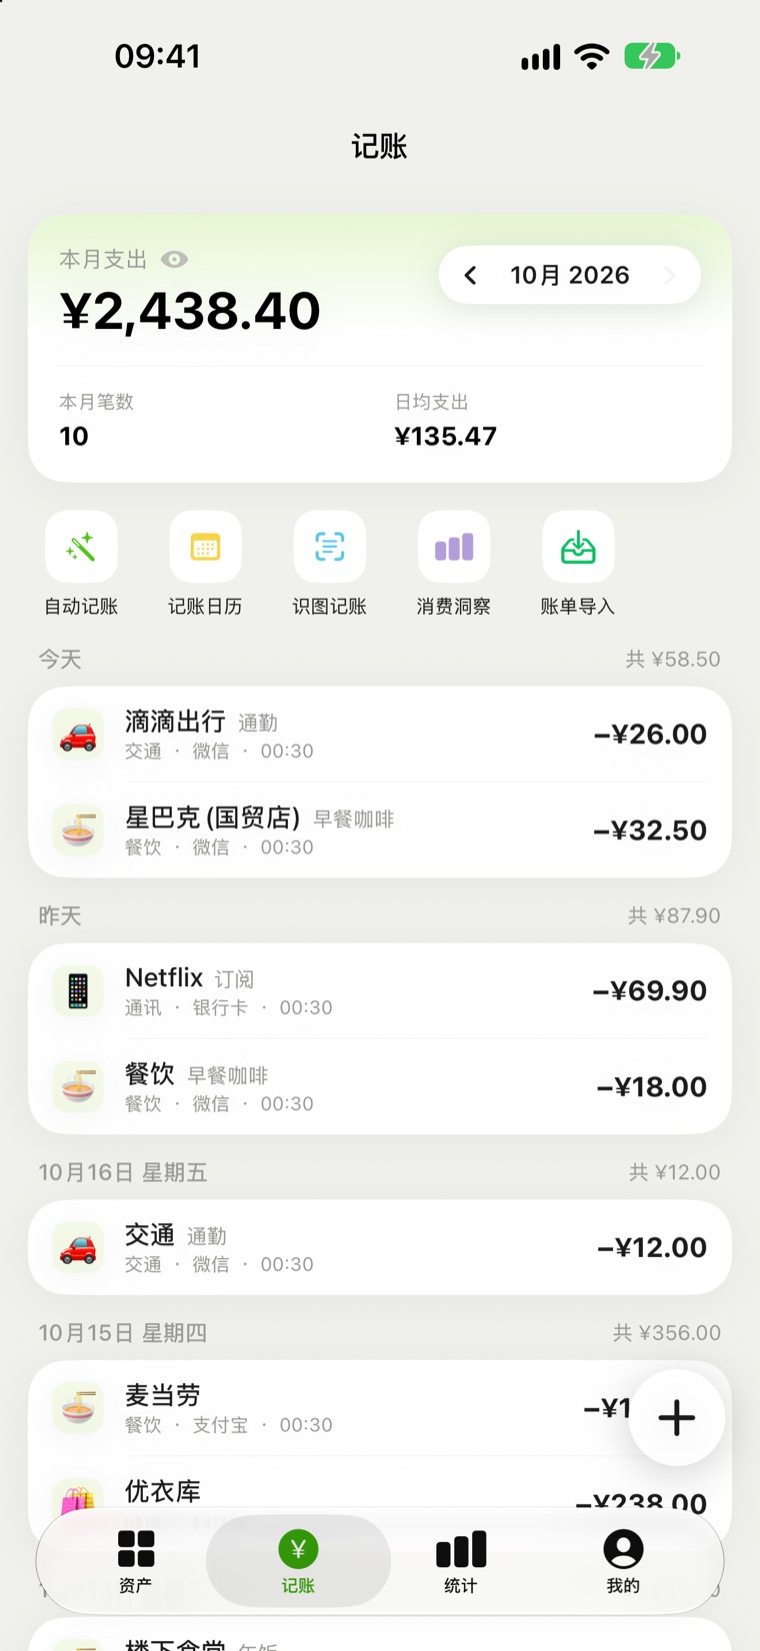
记账 App 最大的流失点不是不好用,是历史账不在这里 。用户装完打开一看,空的。
所以微信、支付宝导出的账单必须能搬进来。而这两家给的文件格式,恰好一个是 XLSX、一个是 GB18030 编码的 CSV。
整个后端和客户端都刻意保持零第三方依赖,所以解析器是自己写的。
先别信扩展名
入口是 fileImporter,用户可能从「文件」、微信、支付宝、邮件附件里选一个文件出来,
扩展名被改过、或者压根没有,都很正常。所以识别按内容不按扩展名 :
读文件头,看到 PK 魔数就是微信的 XLSX,否则按支付宝 CSV 处理。
另一条和文件读取有关的必现坑:fileImporter 回调给的是 security-scoped URL,
不调 startAccessingSecurityScopedResource() 直接读会报「没有查看它的权限」,
从「文件」App 或微信里选来的文件必现。规矩是:在作用域内一次性 Data(contentsOf:)
读进内存,然后才异步解析,defer 里 stop。
手写一个最小的 zip 读法
XLSX 本质就是一个 zip 包,里面装 XML。要读的只有两个部件:
sharedStrings.xml(字符串表)和 xl/worksheets/sheet1.xml(单元格)。
那就按 zip 的格式自己走一遍:
从文件尾往前找 EOCD (End of Central Directory),拿到中央目录的偏移和条目数。
遍历 central directory ,按文件名定位到需要的部件,读出它 local header 的偏移。
跳过 local header,取压缩数据。微信的 XLSX 是 deflate,用
compression_decode_buffer 解 raw deflate —— 这是系统能力,不算依赖。
两段 XML 交给 XMLParser,先把 sharedStrings 摊平成数组,
再按单元格的 t="s" 索引取字符串。
一个 SDK 变更导致的静默失败
XMLParserDelegate 的元素回调方法,参数标签在 iOS 27 SDK 上改成了
qualifiedName qName:。如果还按老写法实现 qName:,
Swift 会认为你实现的是另一个方法 —— 不报错,只给个 warning,
然后 delegate 静默不回调,解析结果一片空白。
这类「签名不匹配 → 协议方法没接上」的失败特别难查,因为程序逻辑上完全正确,只是没在跑。
Excel 的序列日期,锚点必须用固定偏移
XLSX 里日期存的是一个数字:从某个锚点起算的天数。锚点是 1899-12-30 。
用 Calendar / DateComponents 构造这个锚点时,
时区必须写成固定偏移 TimeZone(secondsFromGMT: 8 * 3600),不能用 Asia/Shanghai。
原因是 Asia/Shanghai 在 1901 年之前用的是 LMT,偏移量是
+8:05:43 而不是 +8:00。用命名时区构造 1899 年的锚点,会凭空差出 5 分 43 秒 ——
换算成日期,边界那天就错一天。
这是那种「看起来是时区老问题,其实是时区老问题的历史数据 」的坑。
支付宝的 CSV:编码和头部
支付宝导出的是 GB18030 编码的 CSV,不是 UTF-8。按 UTF-8 读,中文列全是乱码。
头部有约 28 行元数据(导出说明、账号、统计区间),要跳过,真正的表头行以「交易时间」开头 ——
所以还是那句话,按内容定位而不是按行号硬数。
CSV 的引号转义用一个小状态机 splitCSVLine 处理,
因为备注字段里可能出现逗号和转义引号,components(separatedBy: ",") 会切错列。
去重、分类和「只导支出」
导入的账本大概率和本机已有记录重叠 —— 用户可能之前手记过几笔,或者重复导了同一个文件。
去重键是 Int(时间戳) | amount(保留两位):同一时刻、同一金额,认为是同一笔。
用本机已有记录建一个 Set,命中就跳过。
分类走三层:官方分类映射表 → 关键词兜底 → 结果必须属于 App 自己的可见分类集合,
否则归到「其他」。这一层校验是必要的,映射表来自外部文件,写错或过期的可能性得兜住。
只导支出 。收入、中性交易、0 元单会跳过,并且把跳过条数展示给用户看 ——
不写清楚的话,导入完条数对不上,用户以为丢了数据。
写入分批 300 条 ctx.insert 一次 save,然后走既有 的同步通道 push。
不另开一条导入专用的上传路径,是为了让导入的数据天然带上 client_uid,
和手记的记录在幂等语义上完全等价。来源字段新增 alipay / wechat 两个枚举值,
后端白名单同步放行。
截图记账:识别留在本机
另一条录入路径是账单截图。用 App Intents 做「截图记账」快捷指令,
绑定系统的「截屏」自动化之后,每截一张账单图就自动识别一次;
也可以从相册把图分享给这个 App。
识别用 Apple 的 Vision 框架,在本机跑完,图片不上传 。
这既是隐私选择,也是省服务器的选择 —— 但代价是识别质量只能靠规则调。几条经验:
「有没有识别出金额」绝对优先于行数。 一次识别出很多行文字但没有金额的,直接丢掉。弱结果等 0.4 秒换一张备用图再试,最后一步才关掉语言校正。
缩图上限:分享扩展 2000px、快捷指令 2600px。再大对识别没帮助,只增加内存压力。
商户字段不做 OCR —— 它是最后录入的辅助信息,识别错了反而要用户改。
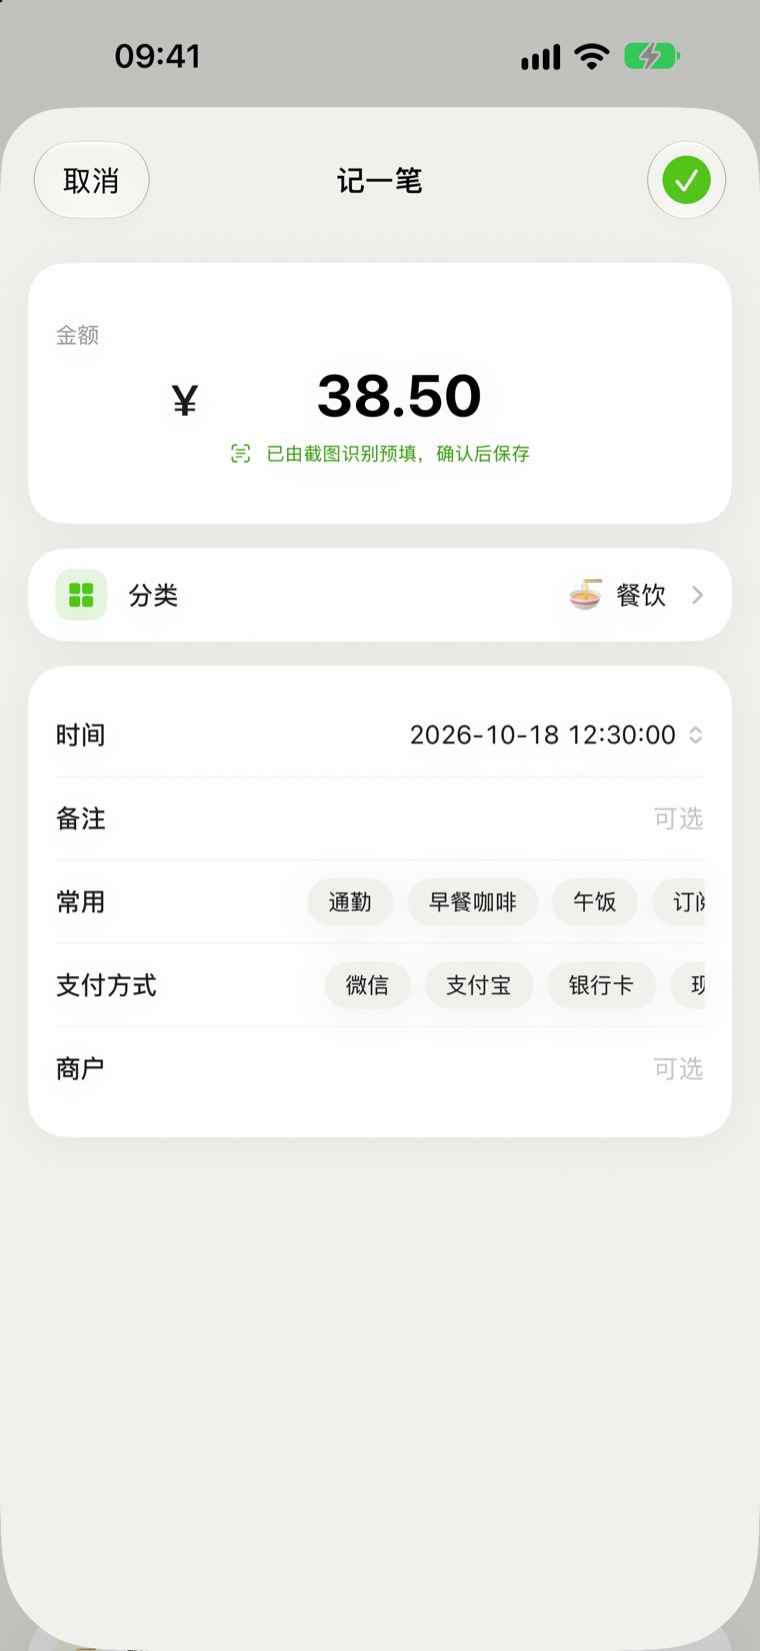
识别出来的结果不直接入账,而是生成一份待确认草稿 ,用户点一下确认才写进账本。
自动化的价值在于少填几个字段,不在于跳过判断。
手记时的字段顺序固定:金额 → 分类 → 时间 → 备注 → 支付方式 → 商户。
导入这件事,做完之后回头看,技术难度不在「解析 XLSX」,而在把外部数据变成自己账本里合法的一条记录 :
编码要对、时区要对、去重要稳、分类要收敛、还得走同一条同步通道。少任何一步,用户看到的都是一句
「导入的数据不对」。